Мадхусудхан Конда | Elasticsearch в действии (2025) [PDF]
Автор: Мадхусудхан Конда
Перевод: И. Печего
Издательство: Алист / БХВ
ISBN: 978-601-08-4524-4
Жанр: Компьютерная литература. Учебное пособие
Формат: PDF
Качество: Изначально электронное (ebook)
Иллюстрации: Цветные и черно-белые
Описание:Это 2-е издание — подробное практическое руководство по работе с поисковой системой Elasticsearch (в частности, покрытие версии 8.17.4) — популярной поисковой системе, позволяющей в реальном времени работать с большими объемами данных. Подробно описаны процессы индексации данных, поиск по полнотекстовым запросам, работа с запросами на уровне терминов и составных запросов, а также анализа и агрегации данных.
Основная информация об издании
Ключевые темы:
- Архитектура, базовые концепции и принципы работы Elasticsearch.
- Установка, настройка и администрирование кластеров и панели Kibana.
- Создание индексов с пользовательскими настройками.
- Работа с API и полнотекстовым поиском.
- Современные подходы: векторный (семантический) и гибридный поиск, интеграция элементов искусственного интеллекта и машинного обучения (AI/ML)
Для кого предназначена:
Разработчики, системные администраторы, DevOps-инженеры и специалисты по работе с данными, для разработчиков приложений и поисковых систем и для всех, кто хочет глубоко погрузиться в мир поисковых систем и использовать Elasticsearch в своих проектах
Оригинальное название: Elasticsearch in Action, Second Edition
Содержание
Отзывы на первое издание
Вступительное слово
Предисловие
Благодарности
Введение
Кому предназначена эта книга
Структура книги
О коде
Форум для обсуждения на странице liveBook
Об авторе
Об изображении на обложке
Глава 1. Краткий обзор
1.1. Что такое хорошая поисковая система?
1.2. Поиск — новая реальность
1.2.1. Структурированные и неструктурированные (полнотекстовые) данные
Структурированные данные
Неструктурированные данные
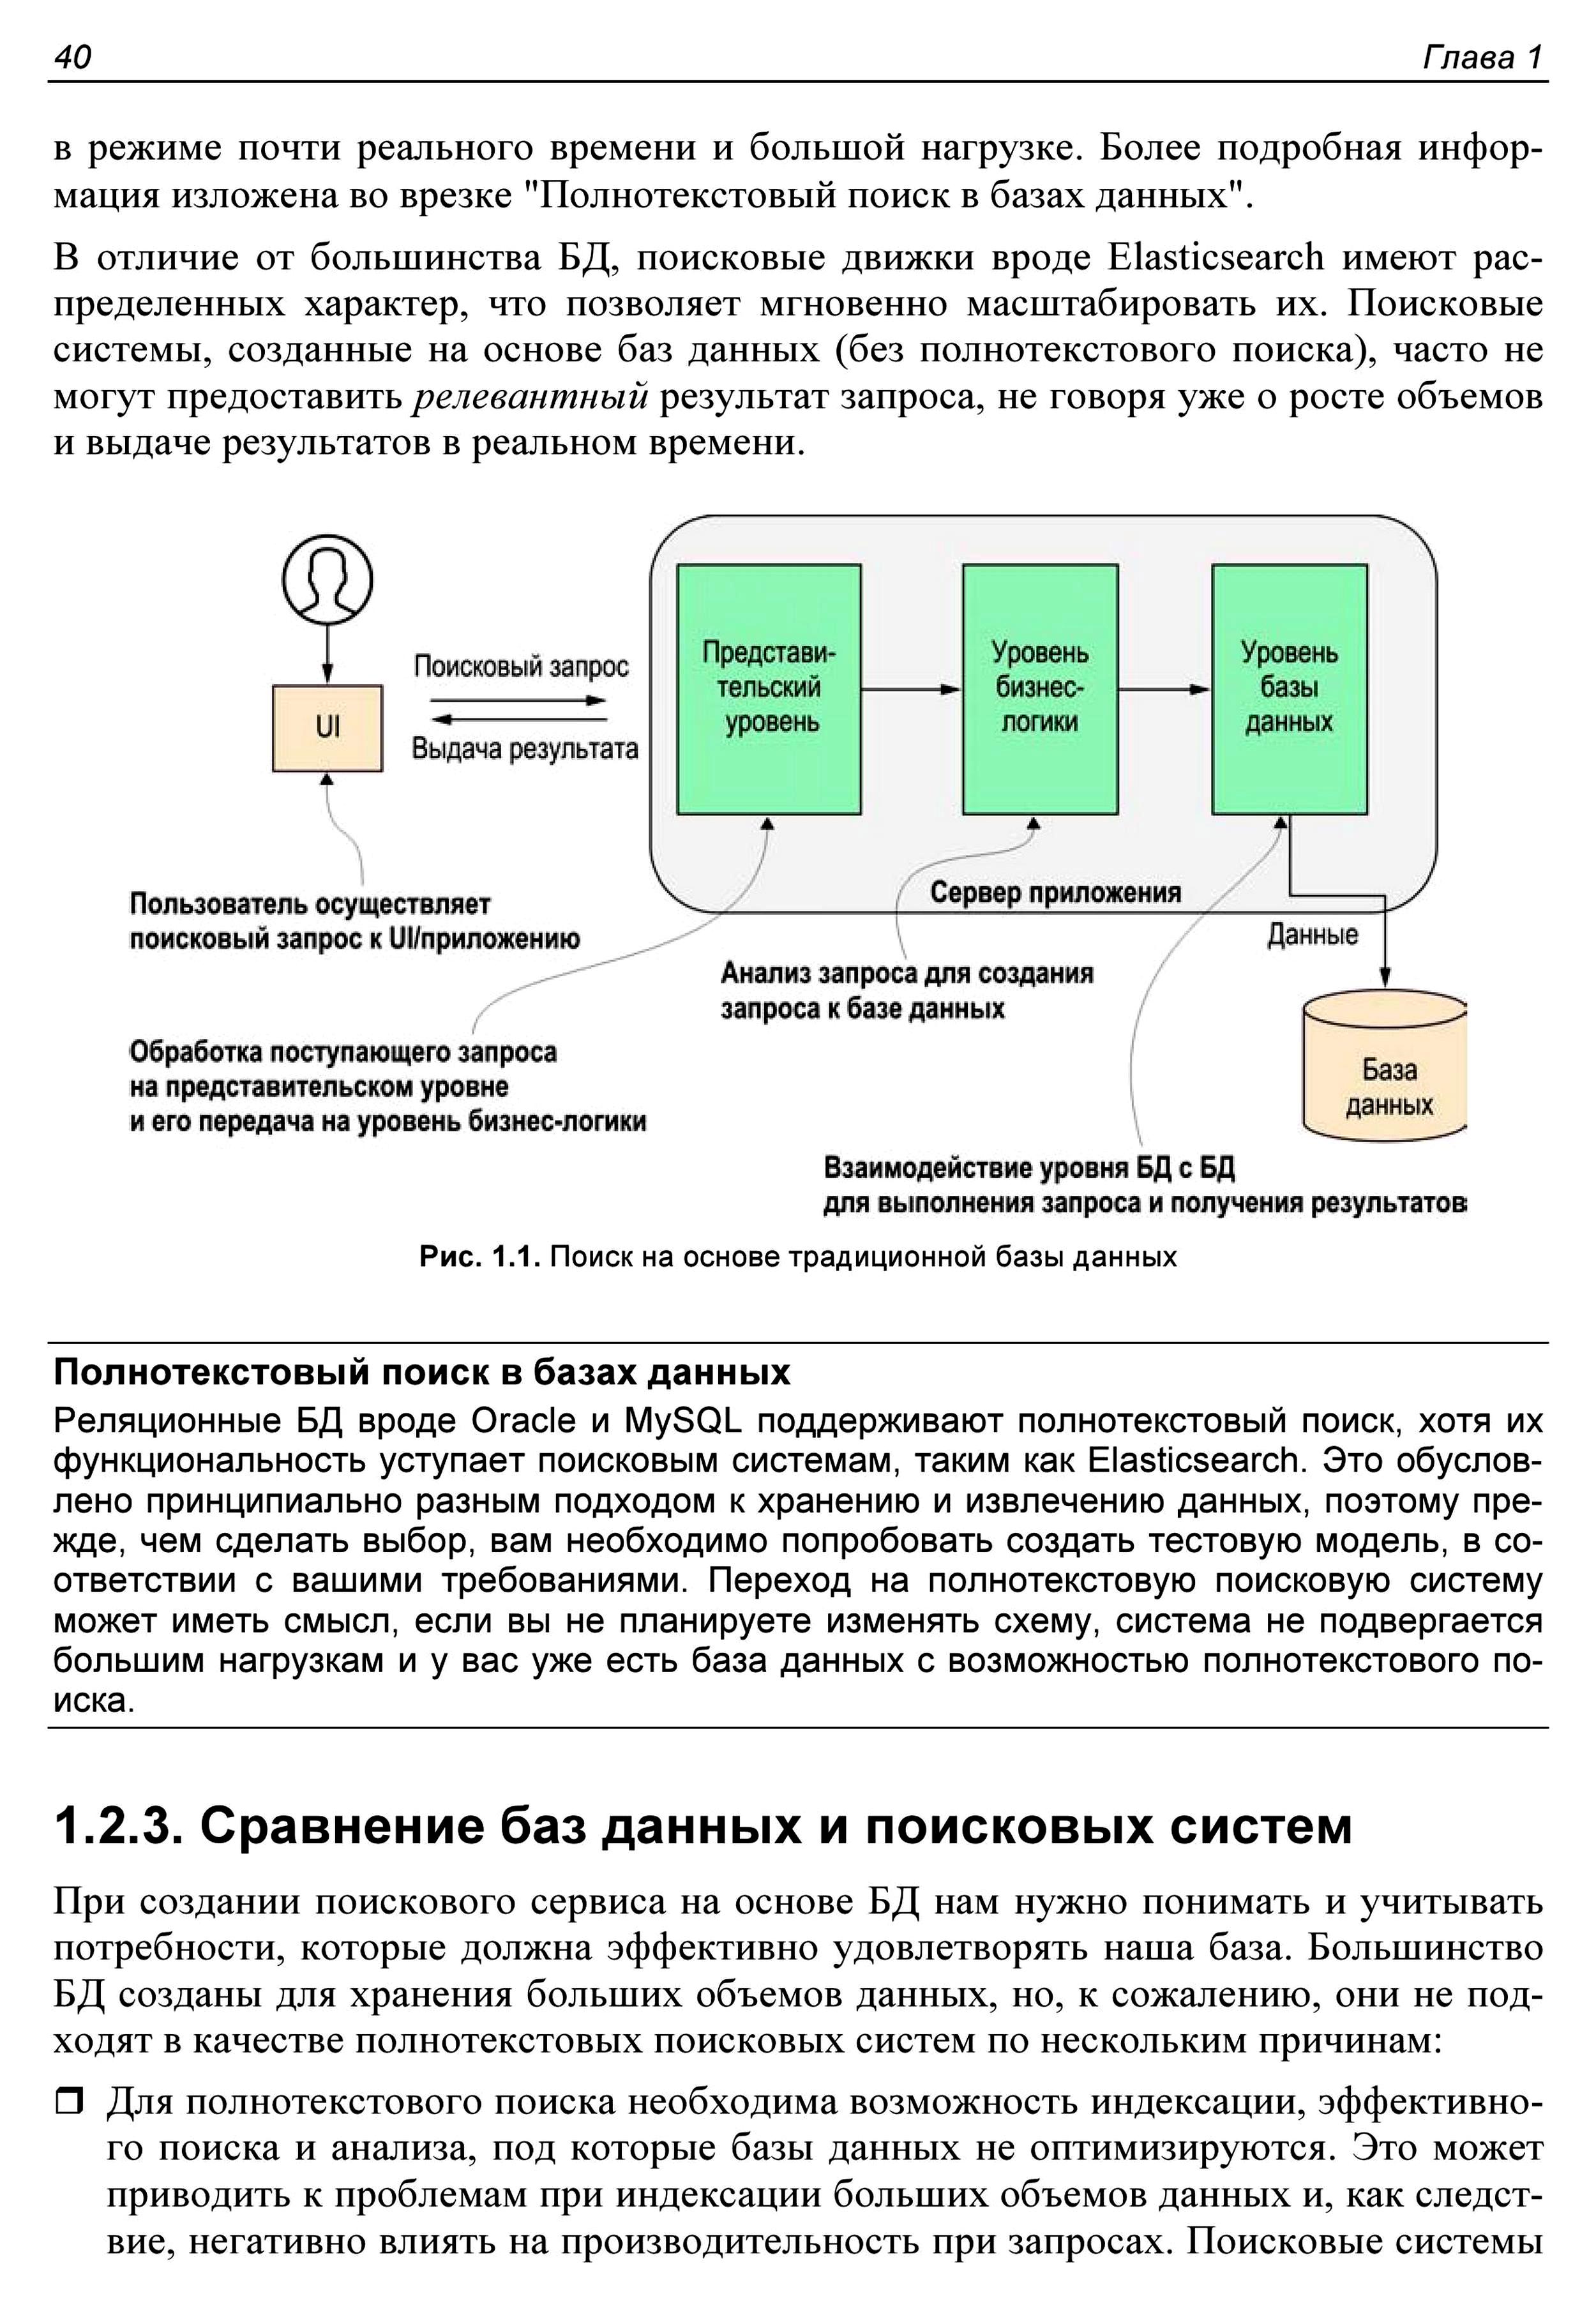
1.2.2. Поиск с использованием базы данных
1.2.3. Сравнение баз данных и поисковых систем
1.3. Современные поисковые системы
1.3.1. Функциональность поисковых систем
1.3.2. Популярные поисковые системы
Elasticsearch
Apache Solr
Amazon opensearch
1.4. Общие сведения о Elasticsearch
1.4.1. Ключевые области применения
Elastic enterprise search
Elastic observability
Elastic security
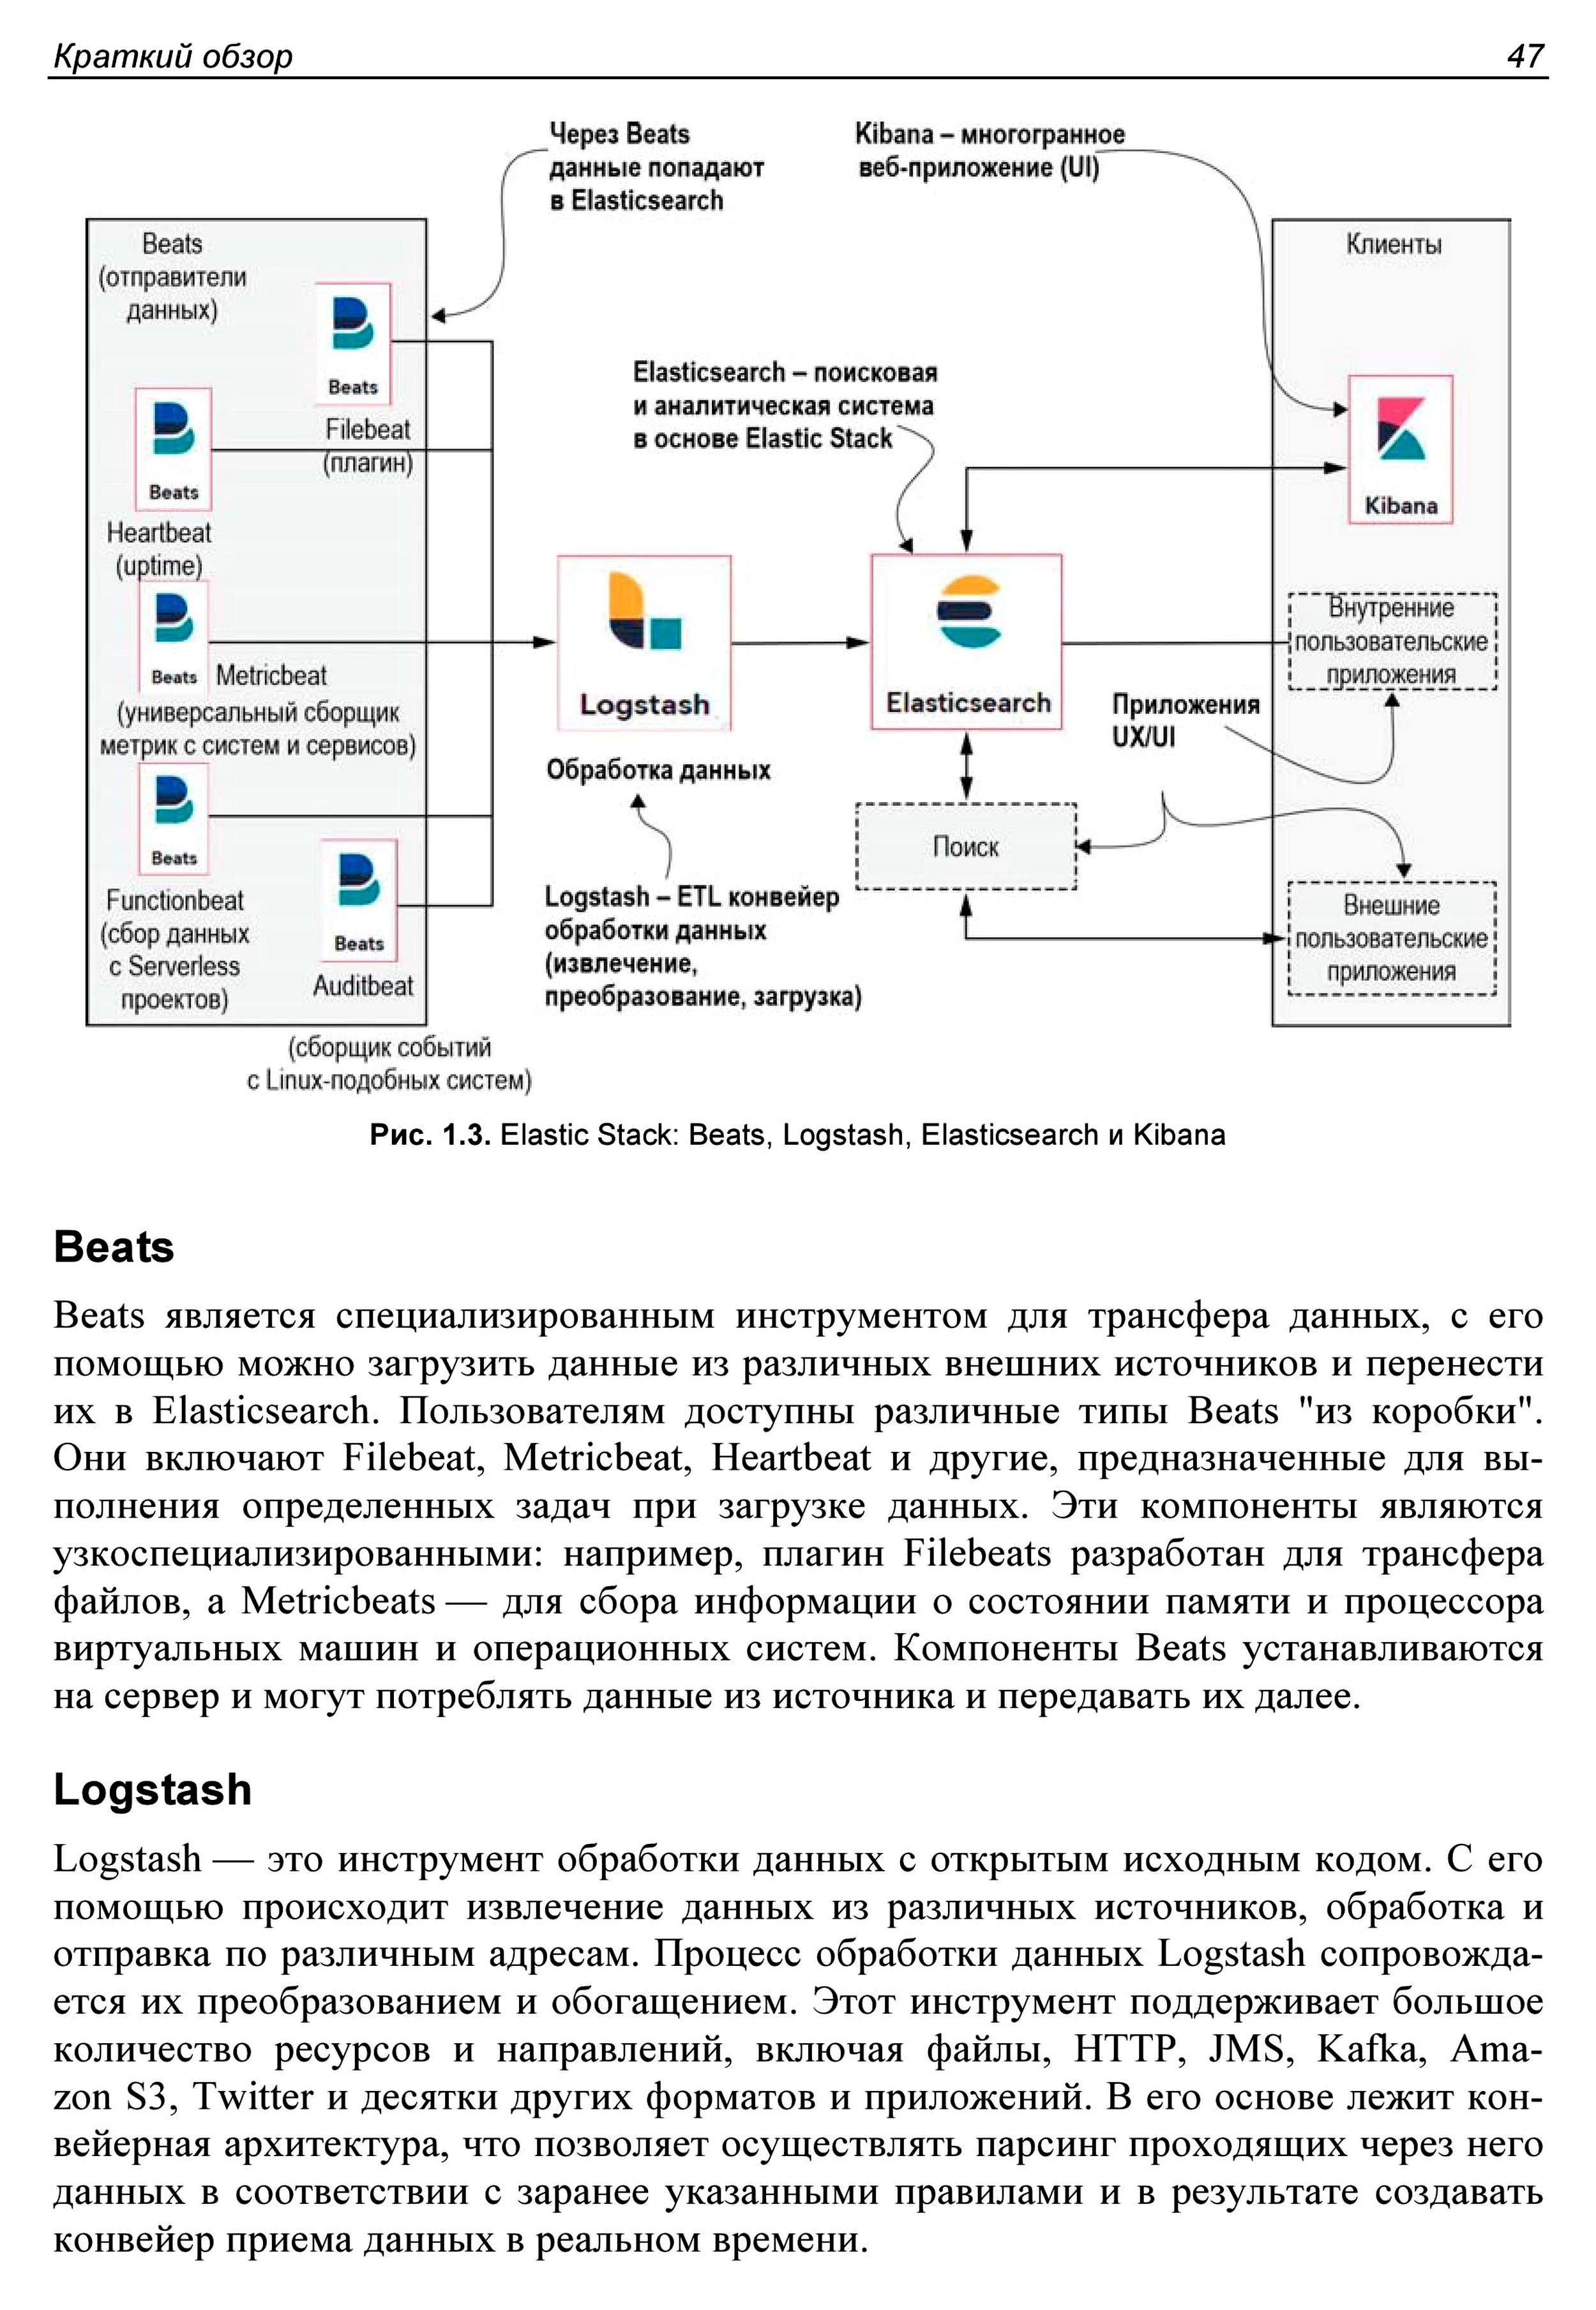
1.4.2. Elastic Stack
Beats
Logstash
Kibana
1.4.3. Способы применения Elasticsearch
Поисковая система
Бизнес-анализ
Анализ безопасности и выявление угроз и мошенничества
Мониторинг логов и приложений
1.4.4. Неподходящие способы применения Elasticsearch
1.4.5. Заблуждения относительно Elasticsearch
1.5. Использование в популярных решениях
1.6. Генеративный ИИ и современный подход к поиску
Итоги
Глава 2. Начало работы с Elasticsearch
2.1. Загрузка данных в Elasticsearch
2.1.1. Книжный интернет-магазин
2.1.2. Индексация документов
API документов
Использование cURL
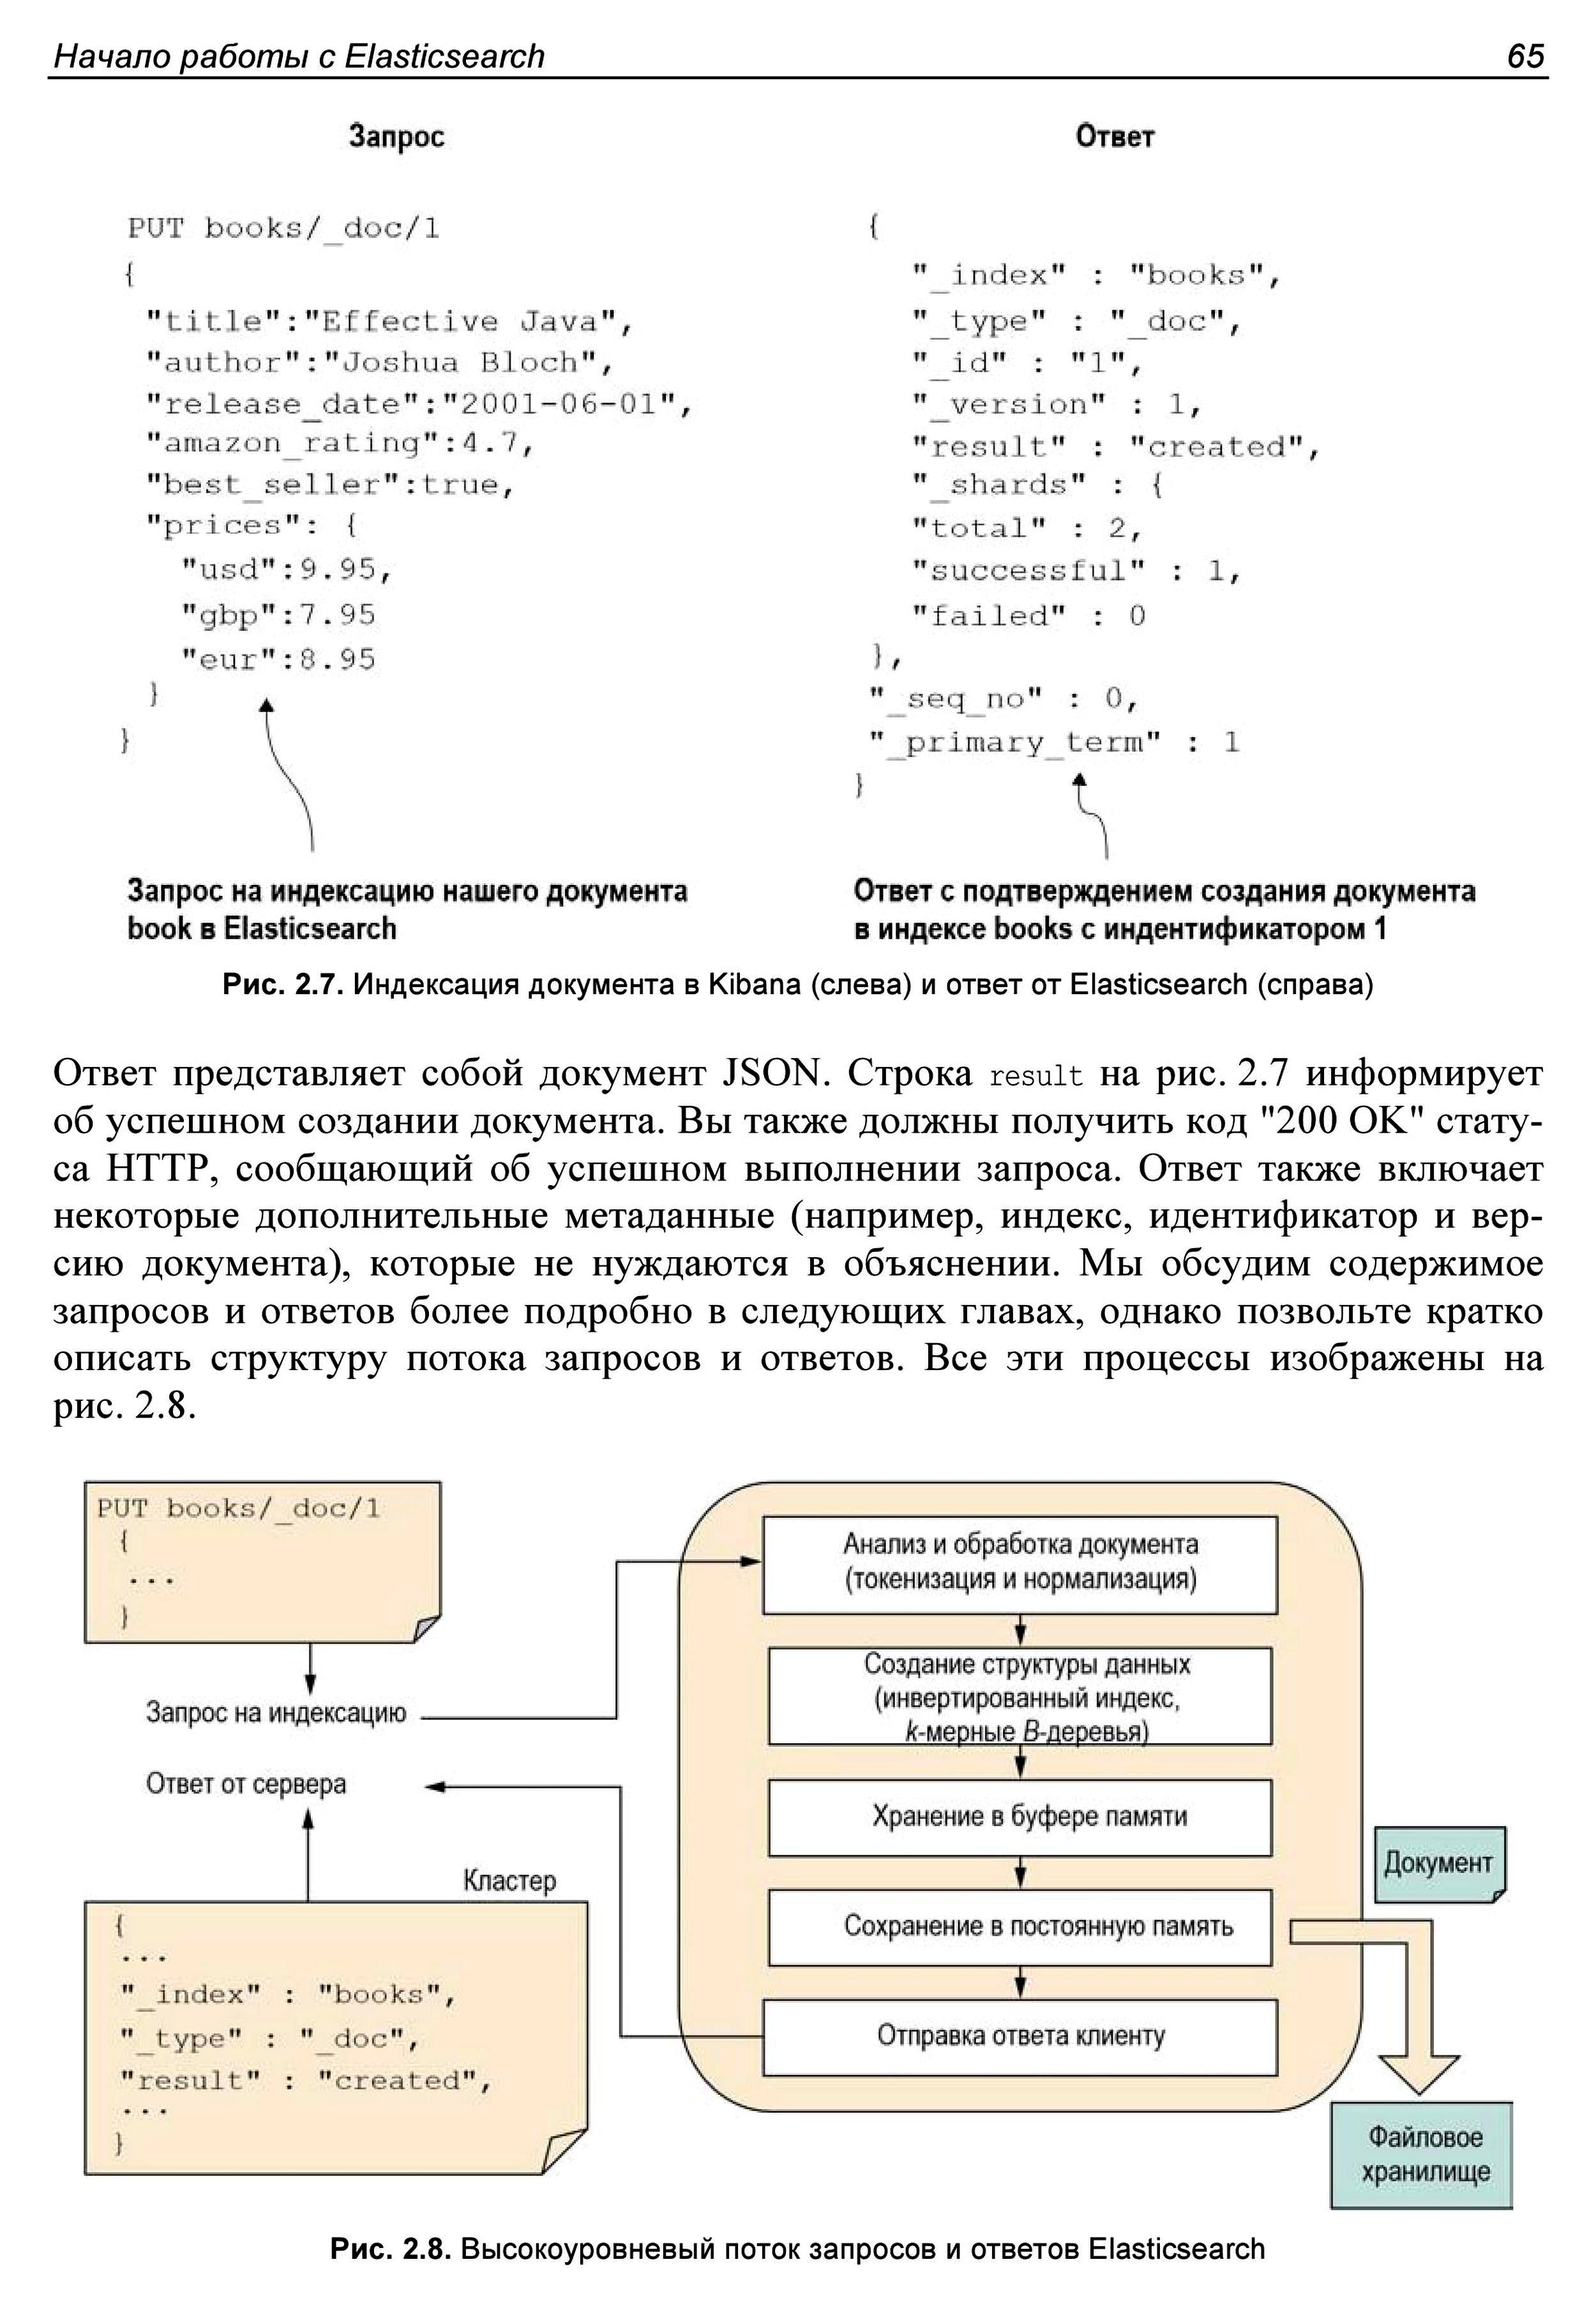
2.1.3. Индексация первого документа
Содержимое запроса
2.1.4. Индексация новых документов
2.2. Извлечение данных
2.2.1. Подсчет документов
2.2.2. Извлечение документов
Извлечение одного документа
Извлечение множества документов с помощью идентификатора
Извлечение всех документов
2.3. Полнотекстовый поиск
2.3.1. Запрос match: поиск книг по имени автора
2.3.2. Запрос match с оператором AND
2.3.3. Индексация документов с помощью API _bulk
2.3.4. Поиск по множеству полей
2.3.5. Поднятие приоритета результатов
2.3.6. Поиск по фразе
2.3.7. Фразы с пропущенными словами
2.3.8. Работа с опечатками
2.4. Запросы для поиска по ключевым словам
2.4.1. Запрос term
2.4.2. Запрос range
2.5. Составные запросы
2.5.1. Логический запрос (bool)
2.5.2. Условие must
2.5.3. Условие must_not
2.5.4. Условие should
2.5.5 Условие filter
2.6. Агрегирование
2.6.1. Метрические агрегаты
Поиск общего числа пациентов в критическом состоянии (метрика sum)
Использование других метрик
2.6.2. Агрегаты сегментов
Сегменты с гистограммами
Сегменты с диапазонами
Итоги
Глава 3. Архитектура
3.1. Общий обзор
3.1.1. Загрузка данных
3.1.2. Обработка данных
Сбор данных
Типы данных
Анализ данных
3.1.3. Извлечение данных
3.2. Составные компоненты
3.2.1. Документы
Парсинг данных документов
Сравнение с реляционной БД
API работы с документами
3.2.2. Индексы
3.2.3. Потоки данных
Данные временных рядов
3.2.4. Шарды и реплики
Распределение шардов и реплик
Повторная балансировка шардов
Размер шарда
3.2.5. Узлы и кластеры
Single-node кластеры
Multi-node кластеры (мультикластеры)
Роли узлов
Конфигурирование ролей
3.3. Инвертированный индекс
3.4. Релевантность
3.4.1. Коэффициент релевантности
3.4.2. Алгоритмы релевантности (сходства)
Алгоритм Okapi BM25
Настройка алгоритмов сходства
3.5. Алгоритм маршрутизации
3.6. Масштабирование
3.6.1. Вертикальное масштабирование
3.6.2. Горизонтальное масштабирование
Итоги
Глава 4. Маппинг
4.1. Что такое маппинг?
4.1.1. Описание маппинга
4.1.2. Первая индексация документа
Анализ полей keyword
4.2. Динамический маппинг
4.2.1. Механизм определения типов данных
4.2.2. Недостатки динамического маппинга
Порождение неправильной схемы маппинга
Упорядочивание при помощи типов keyword
Извлечение неправильных форматов дат
4.3. Явный маппинг
4.3.1. Маппирование с использованием API индексации
4.3.2. Обновление схемы с использованием API маппинга
Обновление пустого индекса
4.3.3. Недопустимость изменения существующих полей
4.3.4. Приведение типов
4.4. Типы данных
4.5. Базовые типы данных
4.5.1. Тип данных text
Анализ текстовых полей
Тип данных token_count
4.5.2. Типы данных keyword
Тип keyword
Тип constant_keyword
Тип данных wildcard
4.5.3. Тип данных date
4.5.4. Числовые типы данных
4.5.5. Тип данных boolean
4.5.6. Типы данных range
Пример типа date_range
4.5.7. Тип данных IP-адресов (ip)
4.6. Продвинутые типы данных
4.6.1. Тип данных geo_point
4.6.2. Тип данных object
Ограничение типа object
4.6.3. Тип данных nested
4.6.4. Тип данных flattened
4.6.5. Тип данных join
4.6.6. Тип данных search_as_you_type
4.7. Поля с множеством типов данных
Итоги
Глава 5. Работа с документами
5.1. Индексация документов
5.1.1. API документов
Идентификаторы документа
Идентификация документа с идентификатором (PUT)
Индексация документа без идентификатора (POST)
Использование _create для предотвращения перезаписи документа
_create API
5.1.2. Компоненты индексации
5.1.3. Настройка процесса обновления
Настройка цикла обновления
Контроль обновления на стороне клиента
5.2. Извлечение документов
5.2.1. Использование однодокументного API
5.2.2. Извлечение множества документов
5.2.3. Запрос ids
5.3. Управление ответами
5.3.1. Исключение метаданных из ответа
5.3.2. Исключение исходного документа из ответа
5.3.3. Включение и исключение полей
Включение полей с помощью _source_includes
Исключение полей с помощью _source_excludes
Включение и исключение полей
5.4. Изменение документов
5.4.1. Механизм изменения документов
5.4.2. _update API
Добавление новых полей
Преобразование существующих полей
5.4.3. Преобразования с помощью скриптов
Преобразование массивов с помощью скриптов
Удаление элемента из массива
Добавление нового поля
Удаление поля
Добавление множества полей
Добавление условия для изменения с помощью скрипта
Устройство скрипта
Передача данных в скрипт
Скриптовые языки
5.4.4. Замена документов
5.4.5. Операция upsert
5.4.6. Изменение с помощью upsert
5.4.7. Изменение с помощью запроса
5.5. Удаление документов
5.5.1. Удаление с помощью идентификатора
5.5.2. Удаление с помощью запроса (_delete_by_query)
5.5.3. Удаление с помощью запроса range
5.5.4. Удаление всех документов
5.6. Работа с группами документов
5.6.1. Формат запроса к _bulk API
5.6.2. Пакетная индексация документа
5.6.3. Независимые сущности и множественные действия
Действие create
Действие update
Действие delete
5.6.4. Пакетные запросы через cURL
5.7. Повторная индексация документов
Итоги
Глава 6. Операции при индексации
6.1. Операции при индексации
6.2. Создание индексов
6.2.1. Неявное создание индекса (автоматическое создание)
Отключение функции автоматического создания индекса
Конфигурации индексов
6.2.2. Явное создание индекса
6.2.3. Индексы с собственными настройками
6.2.4. Индексы с маппингом
6.2.5. Индекс и псевдонимы
Перенос данных без простоя системы с помощью псевдонимов
Операции со множеством псевдонимов с помощью _aliases API
6.3. Чтение индексов
6.3.1. Чтение публичных индексов
6.3.2. Чтение скрытых индексов
6.4. Удаление индексов
Удаление множества индексов
Удаление только псевдонимов
6.5. Остановка и запуск индексов
6.5.1. Остановка индекса
Остановка всех или нескольких индексов
Предотвращение нарушений в работе системы
6.5.2. Запуск индексов
6.6. Шаблоны индексов
6.6.1. Создание компонуемых шаблонов (индексов)
6.6.2. Создание шаблонов компонентов
6.7. Наблюд"ение и управление индексами
6.7.1. Статистические данные индекса
6.7.2. Статистические данные множества индексов
6.8. Продвинутые операции
6.8.1. Дробление индекса
6.8.2. Сжатие индекса
6.8.3. Ротация псевдонимов индекса
Создание псевдонима для операций ротации
Вызов операции ротации
6.9. Управление жизненными циклами индекса (ILM)
6.9.1. Жизненный цикл индекса
6.9.2. Ручное управление жизненными циклами индекса
Этап 1: Определение политик жизненных циклов
6.9.3. Жизненные циклы с ротацией
Итоги
Глава 7. Анализ текста
7.1. Краткий обзор
7.1.1. Запросы к неструктурированным данным
7.1.2. Помощь от анализаторов
7.2. Модули для анализа
7.2.1. Токенизация
7.2.2. Нормализация
7.2.3. Устройство анализатора
7.2.4. Тестирование анализаторов
Тестирование с явным указанием анализатора
Настройка анализаторов на лету
7.3. Встроенные анализаторы
7.3.1. Анализатор standard
Тестирование анализатора standard
Настройка анализатора standard
Настройка обработки шумовых слов
Собственный список шумовых слов из файла
Настройка длины токена
7.3.2. Анализатор simple
7.3.3. Анализатор whitespace
7.3.4. Анализатор keyword
7.3.5. Анализатор fingerprint
7.3.6. Анализатор pattern
7.3.7. Анализаторы для разных языков
7.4. Собственные анализаторы
7.4.1. Продвинутая настройка
7.5. Добавление анализатора
7.5.1. Анализаторы для индексации
Настройка анализатора на уровне поля
Настройка анализатора на уровне индекса
7.5.2. Анализаторы для поиска
Анализатор для запросов
Настройка анализатора на уровне поля
Анализатор по умолчанию на уровне индекса
Приоритет анализаторов
7.6. Фильтры символов
7.6.1. Фильтр hmtl_strip для удаления HTML-тегов
7.6.2. Фильтр символов mapping
7.6.3. Добавление маппингов из файла
7.6.4. Фильтр символов pattern_replace
7.7. Токенайзеры
7.7.1. Токенайзер standard
7.7.2. Токенайзеры ngram и edge_ngram
Токенайзер ngram
Токенайзер edge_ngram
7.7.3. Другие токенайзеры
7.8. Фильтры токенов
7.8.1. Фильтр stemmer
7.8.2. Фильтр shingle
7.8.3. Фильтр synonym
Итоги
Глава 8. Введение в основы поиска
8.1. Краткий обзор
8.2. Как работает поиск?
8.3. Пример данных фильма
8.4. Фундаментальные концепции поиска
8.4.1. Конечная точка _search
8.4.2. Контекст запроса и фильтра
Контекст запроса
Контекст фильтра
8.5. Устройство запроса и ответа
8.5.1. Поисковые запросы
8.5.2. Поисковые ответы
8.6. Поисковые запросы URI
8.6.1. Поиск фильмов по названию
8.6.2. Поиск конкретного фильма
8.6.3. Дополнительные параметры
8.6.4. Поддержка запросов URI с Query DSL
8.7. Query DSL
8.7.1. Пример запроса
8.7.2. Использование cURL с Query DSL
8.7.3. Агрегирование с помощью Query DSL
8.7.4. Листовые и составные запросы
8.8. Функции поиска
8.8.1. Пагинация
8.8.2. Подсвечивание
8.8.3. Коэффициент релевантности
Флаг explain
Explain API
8.8.4. Упорядочивание
Упорядочивание результатов
Упорядочивание по релевантности
8.8.5. Управление результатами
Исключение документов из результатов
Извлечение избранных полей
Скрипты полей
Фильтрация данных источника
8.8.6. Поиск внутри индексов и потоков данных
Итоги
Глава 9. Поиск по ключевым словам
9.1. Краткий обзор поиска по ключевым словам
9.1.1. Запросы для поиска по ключевым словам не анализируются
9.1.2. Примеры запросов для поиска по ключевым словам
9.2. Запрос term
9.2.1. Поиск по ключевым словам с полями text
9.2.2. Пример запроса для поиска по ключевым словам
9.2.3. Сокращенные запросы для поиска по ключевым словам
9.3. Запрос terms
9.3.1. Пример запроса terms
9.3.2. Запрос terms с методом lookup
9.4. Запрос ids
9.5. Запрос exists
9.6. Запрос range
9.7. Запрос wildcard
9.8. Запрос prefix
9.8.1. Сокращенные запросы
9.8.2. Ускорение работы запросов prefix
9.9. Запросы fuzzy
Итоги
Глава 10. Полнотекстовый поиск
10.1. Краткий обзор
10.1.1. Точность
10.1.2. Полнота
10.2. Пример данных
10.3. Запрос match_all
10.3.1. Создание запроса match_all
10.3.2. Сокращенная форма запроса match_all
10.4. Запрос match_none
10.5. Запрос match
10.5.1. Формат запроса match
10.5.2. Поиск с помощью запроса match
10.5.3. Анализ запросов match
10.5.4. Поиск по множеству слов
10.5.5. Поиск совпадений с некоторыми словами
10.5.6. Исправление опечаток с помощью нечеткости ключевых слов
10.6. Запрос match_phrase
10.7. Запрос match_phrase_prefix
10.8. Запрос multi_match
10.8.1. Наилучшие поля
10.8.2. Запрос dis_max
10.8.3. Тайбрейкер
10.8.4. Изменение приоритета отдельных полей
10.9. Запрос query_string
10.9.1. Поля запроса query_string
10.9.2. Операторы по умолчанию
10.9.3. Запрос query_string с фразой
10.10. Нечеткие запросы
10.11. Простые строковые запросы
10.12. Запрос simple_query_string
Итоги
Глава 11. Составные запросы
11.1. Пример бизнес-данных
11.1.1. Схема товаров
11.1.2. Индексация товаров
11.2. Составные запросы
11.3. Логический (bool) запрос
11.3.1. Структура запроса bool
11.3.2. Условие must
11.3.3. Расширение условия must
11.3.4. Условие must_not
11.3.5. Расширение условия must_not
11.3.6. Условие should
Повышение показателя релевантности с помощью условия should
Настройки параметра minimum_should_match
11.3.7. Условие filter
11.3.8. Объединение всех условий
11.3.9. Присвоение имен запросам
11.4. Запрос с фиксированной оценкой
11.5. Повышающий запрос
11.6. Запрос с ранжированием по дизъюнкции (dis_max)
11.7. Запрос function_score
11.7.1. Функция random_score
11.7.2. Функция script_score
11.7.3. Функция field_value_factor
11.7.4. Объединение параметров релевантности функций
Итоги
Глава 12. Продвинутый поиск
12.1. Введение в поиск местоположения
12.1.1. Запрос bounding_box
12.1.2. Запрос geo_distance
12.1.3. Запрос geo_shape
12.2. Типы геопространственных данных
12.2.1. Тип данных geo_point
12.2.2. Тип данных geo_shape
12.3. Геопространственные запросы
12.4. Запрос geo_bounding_box
12.5. Запрос geo_distance
12.6. Запрос geo_shape
12.7. Запрос shape
12.8. Запрос span
12.8.1. Пример данных для работы с запросами span
12.8.2. Запрос span_first
12.8.3. Запрос span_near
12.8.4. Запрос span_within
12.8.5. Запрос span_or
12.9. Специальные запросы
12.9.1 .Запрос distance_feature
Увеличение показателя релевантности при поиске ближайших университетов с помощью геолокации
Увеличение показателя релевантности при работе с датами
12.9.2. Запрос pinned
12.9.3. Запрос more_like_this
12.9.4. Запрос percolate
Итоги
Глава 13. Агрегация
13.1. Краткий обзор
13.1.1. Конечные точки и синтаксис
13.1.2. Объединение поиска и агрегирования
13.1.3. Множественные и вложенные агрегаты
13.1.4. Игнорирование результатов
13.2. Метрические агрегаты
13.2.1. Пример данных для метрических агрегатов
13.2.2. Метрика value_count
13.2.3. Метрика avg
13.2.4. Метрика sum
13.2.5. Метрики min и max
Метрика минимума
Метрика максимума
13.2.6. Метрика stats
13.2.7. Метрика extended_stats
13.2.8. Метрика cardinality
13.3. Обобщенные агрегаты
13.3.1. Гистограммы
Гистограмма на основе интервалов времени
Настройка интервала для гистограммы на основе даты
13.3.2. Агрегат на уровне потомка
13.3.3. Агрегаты с пользовательскими диапазонами
13.3.4. Агрегат terms
13.3.5. Агрегат multi-terms
13.4. Родительские и родственные агрегаты
13.4.1. Родительские агрегаты
13.4.2. Родственные агрегаты
13.5. Конвейерные агрегаты
13.5.1. Типы конвейерных агрегатов
13.5.2. Пример данных для изучения конвейерных агрегатов
13.5.3. Синтаксис конвейерных агрегатов
13.5.4. Доступные конвейерные агрегаты
13.5.5. Родительский агрегат cumulative_sum
13.5.6. Родственные конвейерные агрегаты max_bucket и min_bucket
Агрегат max_bucket
Агрегат min_bucket
Итоги
Глава 14. Администрирование
14.1. Масштабирование кластера
14.1.1. Добавление узлов в кластер
14.1.2. Состояние кластера
14.1.3. Повышение пропускной способности запросов на чтение
14.2. Взаимодействие между узлами
14.3. Выбор размера шарда
14.3.1. Настройка одного индекса
14.3.2. Настройка множества индексов
Вертикальное масштабирование
Горизонтальное масштабирование
14.4. Снимки
14.4.1. Начало работы
14.4.2. Добавление репозитория для снимков
Добавление репозитория с помощью API снимков
Добавление репозитория снимков через Kibana
14.4.3. Создание снимков
14.4.4. Восстановление данных из снимка
14.4.5. Удаление снимков
14.4.6. Автоматизация работы снимков
Управление жизненными циклами с помощью Kibana
Выполнение правил SLM в ручном режиме
14.5. Продвинутые настройки
14.5.1. Главный конфигурационный файл
14.5.2. Опции логирования
14.5.3. Настройка с помощью Java virtual machine
14.6. Мастер-узлы кластеров
14.6.1. Мастер-узлы
14.6.2. Выбор мастер-узла
14.6.3. Состояние кластера
14.6.4. Кворум
14.6.5. Ситуация split-brain
14.6.6. Выделенные мастер-узлы
Итоги
Глава 15. Производительность и решение проблем
15.1. Проблемы со скоростью поиска
15.1.1. Современное оборудование
15.1.2. Моделирование документов
15.1.3. Выбор типов keyword вместо text
15.2. Снижение скорости индексации
15.2.1. Создание идентификаторов системой
15.2.2. Пакетные запросы
15.2.3. Настройка частоты обновления
15.3. Нестабильные кластеры
15.3.1. Состояние кластера не ЗЕЛЕНОЕ
15.3.2. Нераспределенные шарды
15.3.3. Ограничение на использование дискового пространства
Порог low-disk watermark
Порог high-disk watermark
Порог flood-stage-disk watermark
15.4. Автоматические выключатели
15.5. Заключительные слова
Итоги
Приложение А. Установка ПО
А.1. Установка Elasticsearch
А.1.1. Загрузка бинарного файла Elasticsearch
А.1.2. Установка в Windows
А.1.3. Установка в macOS
Доступ к серверу с помощью cURL
А.1.4. Установка в контейнере Docker
Использование Docker-образа
Использование Docker Compose
А.1.5. Тестирование сервера с помощью _cat
А.2. Установка Kibana
А.2.1. Загрузка бинарного файла Kibana
А.2.2. Установка Kibana в Windows
А.2.3. Установка Kibana в macOS
А.2.4. Установка контейнера Docker
Использование Docker-образа
Использование Docker Compose
Приложение Б. Конвейер приема данных
Б.1. Краткий обзор
Б.2. Механики в основе конвейеров приема данных
Б.3. Загрузка файлов PDF в Elasticsearch
Приложение В. Настройка клиентов
В.1. Клиент на Java
В.2. История разработки
В.3. Проект на основе Maven/Gradle
В.4. Инициализация клиента
В.5. Пространство имен клиентов
В.6. Создание индекса
В.7. Индексация документов
В.8. Поиск
Предметный указатель
Скриншоты:
Время раздачи: по мере возможности (минимум до появления первых 3-5 скачавших) 


 (Голосов: